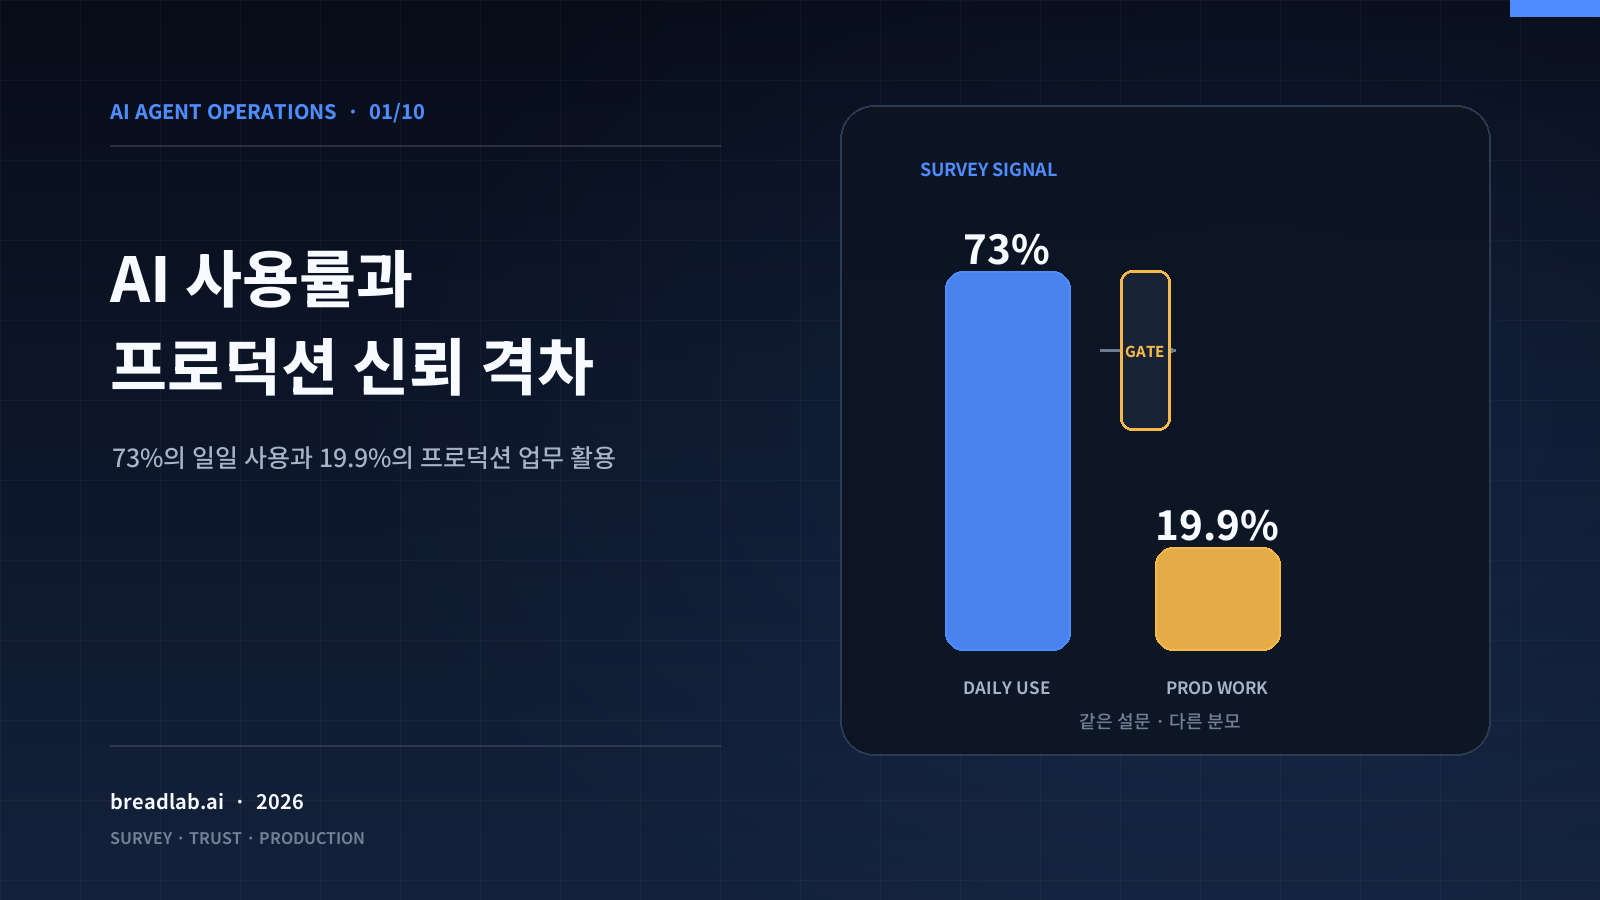
2026 Stack Overflow Developer Survey에는 함께 놓으면 눈에 띄는 두 수치가 있다. AI coding assistants or coding agents 사용자 가운데 73.0%가 해당 도구를 매일 쓴다고 답했다.[1] 별도의 workflow 문항에서는 프로덕션 시스템의 배포·운영·문제 해결에 현재 AI 또는 AI 에이전트를 쓴다는 응답이 19.9%였다.[4]
하지만 이 둘을 곧바로 “매일 쓰는 개발자의 19.9%만 프로덕션 권한을 AI에 위임했다”라고 연결하면 안 된다. 질문도, 응답 집단도, 측정 대상도 다르다. 전자는 특정 도구 유형 사용자의 사용 빈도이고, 후자는 workflow 문항 응답자가 특정 업무에서 AI를 현재 사용하는지 묻는 자기보고다. 어느 문항도 프로덕션 변경 권한의 범위, 사람의 승인 여부, 실제 성공률을 측정하지 않았다.[1][4]
따라서 이 글은 두 비율의 차이를 원인이나 ‘위임률’로 해석하지 않는다. 설문이 직접 말하는 범위를 먼저 확정하고, 그 다음에 조직이 자체 로그와 실험으로 검증할 수 있는 운영 가설을 제안한다. 가역성, 독립 검증, 책임 소재가 갖춰질수록 더 위험한 작업에도 AI를 제한적으로 적용할 수 있다는 가설이다. 이는 설문 결과가 아니라 검증 대상인 운영 제안이다.
숫자마다 분모와 질문이 다르다
설문 결과를 읽을 때 먼저 구분해야 할 문항은 네 가지다.
| 수치 | 설문이 물은 것 | 분모 | 이 수치만으로 말할 수 없는 것 |
|---|---|---|---|
| 73.0% | AI coding assistants or coding agents 사용 빈도 중 Daily |
해당 도구 유형 사용자 | 전체 개발자의 일일 사용률 |
| 65.9% / 62.5% | 현재 업무에서 사용하는 AI 도구 유형 | 해당 문항 전체 응답자 17,464명 | AI 사용자만의 도구 점유율 |
| 30.9% | 매일 AI 도구·에이전트를 쓰는 응답자의 하루 사용 시간 중 4시간 이상 | 해당 문항 응답자 10,926명 | 모든 응답자의 장시간 사용률 |
| 19.9% | 프로덕션 시스템 배포·운영·문제 해결에 현재 AI 또는 AI 에이전트를 사용 | workflow 문항 응답자 12,547명 | 자율 실행률, 권한 위임률, 성공률 |
73.0%는 모든 응답자의 비율이 아니다. 원문 표의 행은 정확히 AI coding assistants or coding agents이고, 그 도구 유형 사용자에게 빈도를 물었을 때 Daily가 73.0%, Weekly가 20.1%, Monthly or Infrequent가 6.2%였다.[1]
도구 유형 문항은 해당 문항의 전체 응답자 17,464명을 분모로 한다. AI coding assistants or coding agents는 11,509명, 65.9%였고, General-purpose AI chat tools는 10,920명, 62.5%였다.[2] 이 문항은 복수 유형을 고를 수 있는 형태이므로 두 비율은 서로 배타적인 시장 점유율도 아니며, “AI 사용자 중 65.9%와 62.5%”라고 표현해서도 안 된다.
매일 AI를 사용한다고 앞서 답한 사람에게 하루 중 사용 시간을 물은 별도 문항에서는 10,926명 가운데 3,378명, 30.9%가 4+ hours/day를 골랐다.[3] 이 수치 역시 전체 설문 응답자나 모든 개발자의 30.9%를 뜻하지 않는다.
workflow 문항은 12,547명을 대상으로 업무마다 현재 사용, 향후 더 사용, 향후 덜 사용, 사용하지 않으며 계획도 없음, 자신의 workflow가 아님을 나눠 물었다. Currently use AI or AI agents for this 비율은 익숙한 영역의 코드 생성 69.3%, 디버깅·문제 해결·리팩터링 63.8%, 프로덕션 시스템 배포·운영·문제 해결 19.9%였다.[4] 여기서 “현재 사용”에는 설명 요청, 분석, 제안, 사람 승인 뒤 실행 등 서로 다른 방식이 포함될 수 있다. 표만으로 그 범위를 분해할 수 없다.
공식 해설의 반올림 수치와 상세표를 섞지 않는다
2026 AI 결과 페이지의 서술형 해설은 익숙한 코드에 AI를 현재 사용한다는 비율을 67%, 디버깅·리팩터링을 61%로 소개한다. 같은 페이지의 업무 요약 시각화는 프로덕션 업무를 20%로 제시한다.[6] 반면 내려받을 수 있는 상세 workflow 표의 Currently use AI or AI agents for this 값은 각각 69.3%, 63.8%, 19.9%다.[4]
두 묶음의 차이는 출처에 귀속해 그대로 밝혀야 한다. 즉 “공식 해설·시각화는 67%·61%·20%, 상세표는 69.3%·63.8%·19.9%”라고 쓴다.[4][6] 공개 페이지가 두 값의 차이가 생긴 이유를 설명하지 않으므로 표본 변경, 필터, 반올림 방식 때문이라고 추정하지 않는다. 이 글에서 세부 비교에는 상세표 값을 사용한다.
이 구분은 단순한 소수점 문제가 아니다. 67%를 상세표의 69.3%와 같은 원자료 값처럼 쓰거나, 20%를 정밀한 위임률처럼 부르면 출처의 표현보다 강한 주장을 하게 된다. 수치는 원문이 측정한 질문과 함께 인용해야 한다.
설문이 보여주는 것과 보여주지 않는 것
신뢰 문항도 같은 원칙으로 읽어야 한다. 14,304명 가운데 48.0%는 “결과를 쉽게 검증할 수 있을 때 신뢰한다”고 답했다. 16.3%는 중요한 업무 결정을 제외한 많은 작업에서, 다른 16.3%는 저위험 업무에서만 신뢰한다고 답했다. 중요한 업무 결정을 포함한 많은 작업에서 신뢰한다는 응답은 6.6%였다.[5]
이 분포는 응답자가 말한 신뢰 조건을 보여준다. 그러나 48.0%와 프로덕션 업무 활용 19.9%를 연결해 “검증이 어려워서 프로덕션 사용이 낮다”고 인과적으로 결론 내릴 수는 없다. 서로 다른 문항이고, 동일 응답자를 연결한 분석도 이 표에는 없다.[4][5] 접근 권한, 조직 정책, 직무 구성, 규제, 도구 가용성, 업무 필요성 등 다른 요인이 작용했을 수 있다.
조사 자체의 범위도 제한해 읽어야 한다. 2026 설문은 6월 23일부터 8월 5일까지 기록된 39,266개 행 가운데 30,903개를 유효 응답으로 사용했고 169개 국가의 응답을 포함했다. 설문은 Stack Overflow 웹사이트와 블로그, 연구 또는 공지 이메일 수신에 동의한 커뮤니티 구성원에게 홍보됐다.[7] 따라서 이 결과는 해당 모집 경로를 통해 참여한 응답자의 자기보고이며, 전 세계 개발자 전체를 확률 표집한 관측으로 확대하면 안 된다.
정리하면 설문에서 직접 확인할 수 있는 것은 다음과 같다.
- 특정 AI 코딩 도구 유형 사용자에게서는 일일 사용이 흔하다.[1]
- 도구 유형 문항 전체 응답자 17,464명 중 65.9%가
AI coding assistants or coding agents, 62.5%가General-purpose AI chat tools를 현재 업무에서 쓴다고 답했다.[2] - 일일 사용자 대상 시간 문항에서는 30.9%가 하루 네 시간 이상이라고 답했다.[3]
- workflow 문항에서 현재 활용은 익숙한 코드 생성 69.3%, 디버깅·문제 해결·리팩터링 63.8%, 프로덕션 배포·운영·문제 해결 19.9%였다.[4]
- 신뢰는 쉽게 검증 가능한 결과, 저위험 작업, 중요 결정의 포함 여부에 따라 다르게 보고됐다.[5]
반대로 설문만으로는 AI가 프로덕션 변경을 자율 실행했는지, 사람이 어느 단계에서 승인했는지, 실패 비용이 얼마였는지, 왜 업무별 비율이 달라졌는지를 알 수 없다. 특히 19.9%를 “프로덕션 권한 위임률”로 바꾸어 부르지 않는 것이 중요하다.
공개 집계표를 엮을 때 지켜야 할 세 가지 규칙
첫째, 같은 사람이 두 문항에 모두 답했다고 가정하지 않는다. 문항별 응답자 수가 다르면 73.0% 집단과 19.9% 집단의 교집합을 공개 집계만으로 계산할 수 없다. 두 비율을 곱해 “매일 쓰면서 프로덕션에도 쓰는 사람”의 규모를 추정하는 것도 근거가 없다. 그런 분석에는 응답자 수준의 교차표나 원자료가 필요하다.
둘째, 행동의 강도를 임의로 채우지 않는다. Currently use AI or AI agents for this는 사용 여부를 나타내지만, 로그 읽기·원인 후보 제안·배포 명령 생성·승인 후 실행·무인 실행을 구분하지 않는다.[4] 따라서 같은 19.9% 안에서도 권한과 위험은 크게 다를 수 있다. 운영 설계는 이 한 개 비율을 목표로 삼는 대신 실제 action과 승인 지점을 별도로 기록해야 한다.
셋째, 문항 사이의 차이에 원인을 붙이지 않는다. 익숙한 코드와 프로덕션 업무의 활용률 차이는 관측값이지만, 왜 그런 차이가 생겼는지는 조사되지 않았다. 모델 정확도, 도구 접근성, 회사 정책, 규제, 직무 구성, 사고 비용 가운데 무엇이 얼마나 작용했는지 공개표로 분리할 수 없다. 원인을 검증하려면 조직 내부에서 유사한 작업군을 정하고 권한·검증·복구 조건을 바꾼 전후 결과를 비교해야 한다.
이 규칙을 지키면 설문은 약해지는 것이 아니라 더 쓸모 있어진다. 공개 집계는 시장 전체의 위임률을 선언하는 숫자가 아니라, 내부 계측에서 무엇을 분리해야 하는지 알려 주는 질문 목록이 된다.
차이는 결론이 아니라 운영 가설의 출발점이다
상세표에서 익숙한 코드 생성과 프로덕션 업무 활용 사이에는 49.4%p의 차이가 있다.[4] 이 산술적 차이는 두 업무에 “현재 사용”이라고 답한 비율이 다르다는 사실만 표현한다. 프로덕션의 위험 때문에 차이가 생겼다거나, 신뢰 부족이 원인이라는 설명은 별도 검증이 필요하다.
조직이 검증할 수 있는 가설은 다음처럼 좁게 세울 수 있다.
작업의 영향 범위를 제한하고, 결과를 실행 주체와 독립적으로 확인하며, 중단·복구 책임자를 명시하면, 같은 종류의 프로덕션 업무에서 AI 활용 가능 범위를 안전하게 넓힐 수 있다.
이 가설은 “더 좋은 모델이면 더 많이 맡길 수 있다”보다 측정하기 쉽다. 적용 전후에 승인 소요 시간, 독립 read-back 성공률, 잘못된 변경의 탐지 시간, rollback 성공률, 고객 영향, 사람 개입률을 비교할 수 있기 때문이다. 결과가 나쁘면 범위를 줄이거나 가설을 폐기할 수도 있다.
중요한 것은 설문 수치를 조직 정책의 근거로 곧장 사용하는 대신, 내부 관측으로 번역하는 일이다. 예를 들어 “프로덕션 활용이 19.9%이니 우리도 20%를 목표로 하자”는 목표는 업무 구성과 권한 모델을 무시한다. 반면 “어떤 작업이 읽기·제안·제한된 실행 중 어디까지 허용됐고, 각 단계의 실패와 복구가 어땠는가”는 자체 데이터로 답할 수 있다.
최소한의 자율성 구분
기존 운영 설계에서 sandbox, 최소 권한, telemetry, audit log 같은 구현 항목은 이미 중요하게 다뤄진다. 여기서는 중복된 체크리스트를 늘리기보다 설문 수치를 오독하지 않기 위한 최소 구분만 둔다.
| 단계 | 허용 범위 | 다음 단계로 가기 전에 필요한 증거 |
|---|---|---|
| Read | 코드·문서·로그를 읽고 근거와 함께 설명 | 입력 시점과 출처 재현, 사실과 추정 분리 |
| Propose | patch·명령·rollback 계획을 제안하되 실행하지 않음 | 대상 version 일치, 예상 diff, 사람 승인 기록 |
| Reversible write | 작은 범위의 변경 실행 | 독립 read-back, 실제 rollback 훈련, 영향 상한 |
| Guarded production action | 사전 정의된 production 동작만 실행 | 자동 중단 조건, 복구 책임자, 잔여 효과 확인 |
이 단계는 산업 표준이나 설문 분류가 아니라 운영 가설을 시험하기 위한 내부 분류다. “AI를 쓴다”를 하나의 상태로 취급하지 않고, 읽기와 쓰기, 제안과 실행, 가역 작업과 비가역 작업을 나누는 목적이다. 같은 팀이 네 단계를 동시에 사용할 수도 있고, 한 업무에서 성공했다고 다른 업무를 자동 승급해서도 안 된다.
검증 질문도 세 묶음이면 충분하다.
- 가역성: 틀렸음을 어떤 신호로 언제 알며, 그 전에 허용되는 최대 영향은 얼마인가? rollback을 최근 실제로 실행했는가? 되돌려도 남는 외부 메시지·결제·데이터 효과는 무엇인가?
- 증거: 에이전트가 본 입력의 시간·version·환경을 재구성할 수 있는가? 실행 요청과 실제 변경을 별도 read-back으로 확인하는가? 관측값이 없을 때 성공이 아니라 중단으로 처리하는가?
- 책임: 누가 범위를 승인하고, 누가 즉시 중단하며, 누가 복구와 고객 설명을 소유하는가? 담당자가 없을 때 권한이 자동으로 낮아지는가?
답을 문서에 적는 것만으로는 가설이 검증되지 않는다. 제한된 작업군을 정하고, 사전 기준과 결과를 비교해야 한다. 예를 들어 한 달 동안 제안 단계의 변경 중 실제 실행된 비율, 실행 직전 상태 변경으로 폐기된 비율, 실행 후 독립 확인 실패율, rollback 시간과 잔여 효과를 기록한다. 그 결과를 사람이 직접 수행한 유사 작업 또는 이전 기간과 비교하되, 작업 난이도와 영향 등급을 함께 통제한다.
측정 단위는 채택률이 아니라 작업 계약이다
주간 활성 사용자, prompt 수, 생성 코드량은 도구 채택을 보여주지만 프로덕션 권한을 보여주지 않는다. 내부 dashboard에는 최소한 다음이 필요하다.
- 작업 유형별
read / propose / reversible write / guarded production action건수 - 제안과 실제 실행 사이에 대상·version이 달라져 취소된 비율
- 실행 뒤 독립 read-back 성공률과 확인까지 걸린 시간
- 중단 조건이 작동한 건수와 중단 전 최대 영향
- rollback 시도·성공률, 복구 시간, 남은 side effect
- 승인자, 중단 담당자, 복구 책임자가 기록되지 않아 실행하지 않은 건수
이 지표에도 방향을 미리 부여하면 안 된다. 중단률 상승은 모델 품질 저하일 수도 있지만, 새 guard가 위험한 실행을 더 잘 막은 결과일 수도 있다. 자동 실행률 상승 역시 성숙도의 증거가 아니라 쉬운 작업만 남겼거나 검증 절차를 줄인 결과일 수 있다. 작업 위험 등급과 함께 보고, 실패·near miss를 포함해 해석해야 한다.
운영 가설을 지지하려면 최소한 “범위를 넓힌 뒤에도 고객 영향과 복구 시간이 사전 상한 안에 있었고, 독립 검증 누락이 늘지 않았다”는 결과가 필요하다. 반대로 영향이나 검증 누락이 증가하면 자율성 단계를 낮춰야 한다. 이처럼 반증 조건을 먼저 정해야 설문에서 출발한 아이디어가 구호가 아니라 실험이 된다.
결론: 서로 다른 비율을 하나의 서사로 만들지 말자
2026 설문에서 73.0%는 AI coding assistants or coding agents 사용자의 일일 사용 빈도이고, 19.9%는 별도 workflow 문항에서 프로덕션 시스템 배포·운영·문제 해결에 현재 AI 또는 AI 에이전트를 쓴다는 응답 비율이다.[1][4]
65.9%와 62.5%는 AI 사용자만이 아니라 해당 도구 유형 문항 전체 응답자 17,464명을 분모로 한다.[2] 30.9%와 신뢰 수치에도 각각 별도의 질문과 분모가 있다.[3][5]
이 자료는 AI 코딩 도구의 빈번한 사용과 업무별 활용 분포를 보여주지만, 프로덕션 권한 위임이나 업무별 차이의 원인을 측정하지 않았다. 따라서 “많이 쓰지만 믿지 않아 맡기지 않는다”는 문장은 조사 결과가 아니다. 가능한 해석 중 하나일 뿐이며, 공개표만으로 검증되지 않았다.
조직이 할 수 있는 일은 원인을 단정하는 대신 검증 가능한 작업 계약을 만드는 것이다. 읽기, 제안, 가역적 쓰기, 경계가 있는 프로덕션 실행을 구분하고, 각 단계에서 영향 상한·독립 read-back·중단 조건·책임자를 기록한다. 그런 내부 증거가 쌓였을 때만 어떤 조건이 활용 범위를 넓히거나 줄였는지 말할 수 있다. 설문의 역할은 답을 대신하는 것이 아니라, 무엇을 따로 측정해야 하는지 드러내는 데 있다.
Sources
[1] https://survey.stackoverflow.co/2026/ai/data/ai-freq [2] https://survey.stackoverflow.co/2026/ai/data/ai-select [3] https://survey.stackoverflow.co/2026/ai/data/ai-daily [4] https://survey.stackoverflow.co/2026/ai/data/ai-work [5] https://survey.stackoverflow.co/2026/ai/data/ai-trust [6] https://survey.stackoverflow.co/2026/ai/ [7] https://survey.stackoverflow.co/2026/methodology/