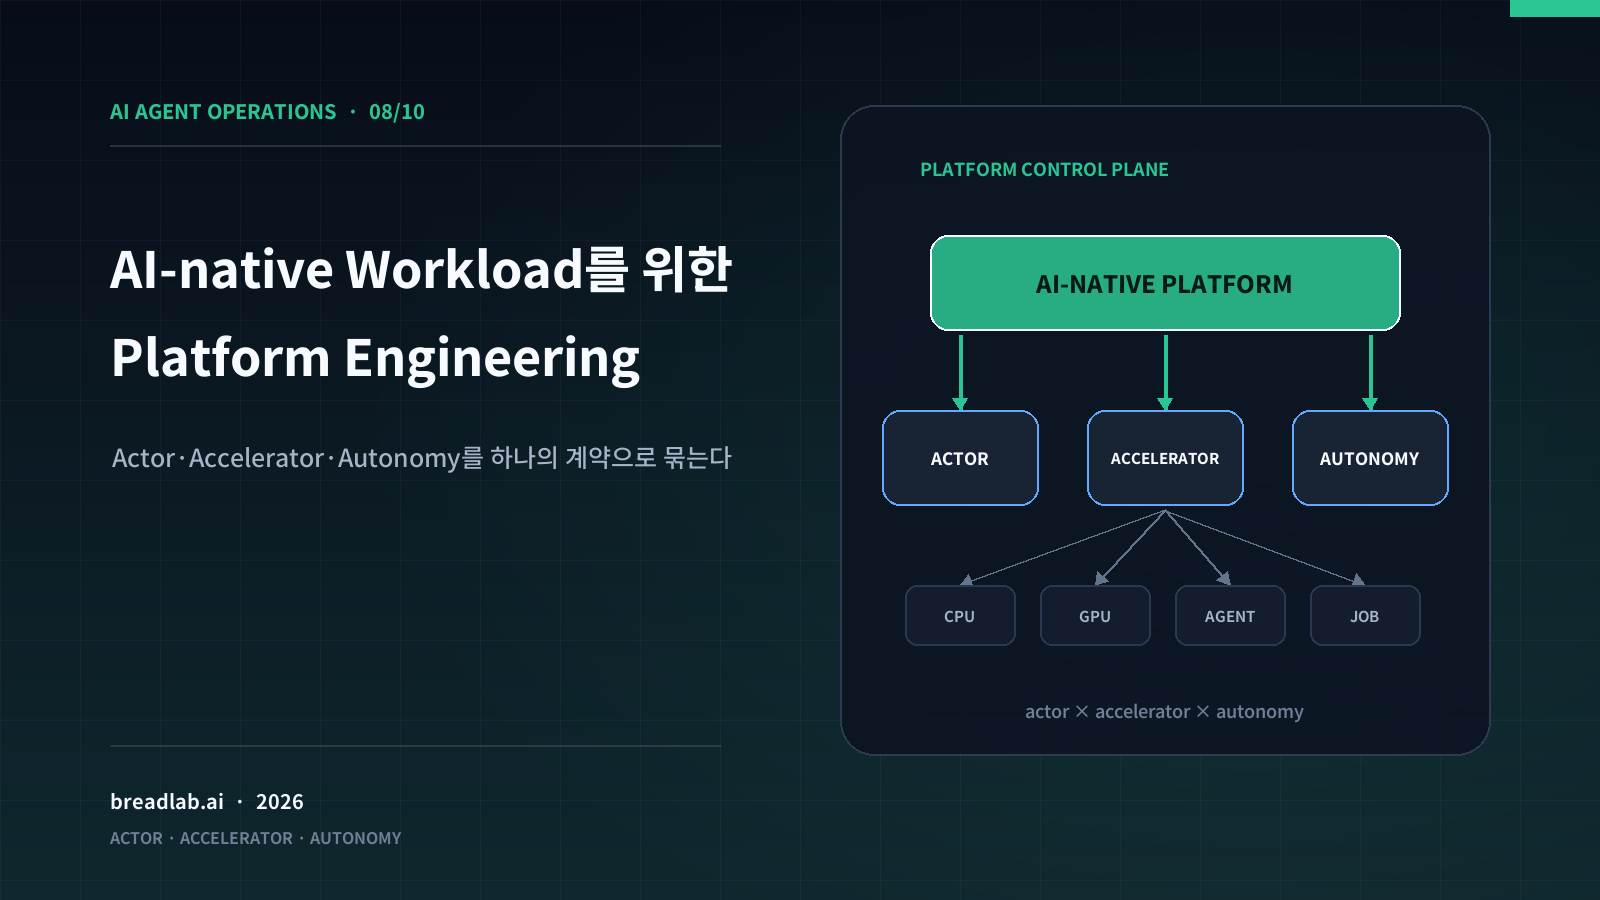
기존 IDP는 개발자가 저장소를 만들고 CPU·메모리와 환경을 골라 웹 서비스를 배포하는 흐름에 맞춰졌다. 플랫폼은 사람의 요청을 기다리고 비용은 사후 집계하며 정책은 배포 전에 통과하면 된다고 가정한다. Golden Path 자체는 유효하지만 승객은 사람, 희소 자원은 범용 compute, 변경 속도는 사람의 검토 속도라는 전제가 문제다.
AI-native workload는 세 전제를 동시에 흔든다. ML engineer는 코드뿐 아니라 dataset·model·evaluation을 함께 이동시킨다. Training과 inference는 accelerator 종류, memory, topology, queue를 배포 계약에 끌어들인다. AI agent는 API를 반복 호출하고 운영 변경까지 시도하는 non-human actor다. 핵심 질문은 “GPU plugin을 설치했는가”가 아니라 누가(actor), 어떤 희소 자원(accelerator)을, 어느 자율성(autonomy)으로 소비해도 되는가다.
먼저 경계부터: CNCF 표준이 아니라 CNCF에 실린 제안이다
CNCF에 게재된 글은 이 변화를 “Platform Engineering 2.0”이라 부르고, AI-Native Platform, Multi-Persona Experience, Embedded FinOps, Security Shifts Down, Composable by Design의 다섯 축으로 설명한다.[1] 다만 이것은 CNCF 인증이나 합의된 표준 이름이 아니다. 글의 저자가 제시한 framework이며, 원문도 “one way to think”라고 범위를 한정한다.[1] 그러므로 조직이 “2.0 준수” badge를 만들기보다 어떤 운영 계약이 실제로 바뀌어야 하는지 검증하는 편이 낫다.
수요가 단지 유행이라고 보기도 어렵다. 다만 2025 CNCF Annual Survey의 수치를 한 모집단처럼 읽어서는 안 된다. 생성형 AI workload의 일부 또는 전부를 Kubernetes에서 운영한다는 66%는 Q41의 213개 응답, model을 직접 build·train하지 않는다는 52%는 Q39의 497개 응답, production model을 매일 배포한다는 7%는 Q42의 183개 응답을 각각 분모로 삼으며 DKNS는 제외했다.[2] 세 문항은 서로 다른 표본이다. 따라서 이는 “모든 회사가 대규모 training cluster를 지어야 한다”는 근거가 아니라 managed API, self-hosted inference, 제한적 fine-tuning 수요가 공존한다는 신호로만 읽어야 한다.
CNCF Cloud Native AI whitepaper도 ML lifecycle을 data preparation, training, CI/CD와 model registry, serving, observability로 나누고, model drift·GPU allocation·data governance·artifact provenance를 별도 문제로 다룬다.[3] 기존 code → build → deploy 경로에 GPU 메뉴 하나를 붙이는 방식으로는 이 lifecycle을 표현할 수 없다.
이제부터 제시할 actor–accelerator–autonomy 모델은 CNCF의 공식 세 축이 아니라 이 글의 운영 제안이다. CNCF 글의 다섯 pillar를 구매 목록으로 옮기지 않고, 기존 Golden Path의 입력·정책·증거를 확장하기 위한 재구성이다.
왜 인간 속도·CPU 중심 가정이 깨지는가
기존 IDP catalog는 service owner와 repository를 중심으로 설계됐다. 그러나 같은 endpoint를 두고 ML engineer는 model과 evaluation을, 개발자는 API와 SLO를, FinOps는 token·GPU-hour 비용을, security는 model·dataset·region 정책을 본다. Agent는 화면 대신 API를 호출한다. Persona별 portal, notebook script, MCP tool, 사후 dashboard를 따로 만들면 서로 같은 정책을 집행하는지 증명하기 어렵다. 필요한 것은 여러 client가 공유하는 하나의 resource contract다.
cpu: 2, memory: 4Gi만으로도 부족하다. Accelerator family·memory·topology·runtime compatibility·job duration이 결과와 비용을 바꾼다. 그러나 DRA나 Kueue의 object를 portal에 그대로 노출하는 것도 답은 아니다. Vendor SKU와 CRD version은 latency-critical-inference, interruptible-training 같은 workload intent 뒤에 숨겨야 한다.[4][5]
사람은 form을 한 번 제출하지만 agent는 검색, preview, 배포, 관측, rollback을 반복한다. 호출별 권한만으로는 빈도·누적 비용·동시성·승인 후 argument 변경을 통제하지 못한다. SPIFFE가 규정하는 것은 SVID 형식과 Workload API 규격이며, SPIRE 같은 구현이 workload를 attestation해 SVID를 발급·회전한다.[9][14] 어느 쪽도 특정 운영 action의 승인을 뜻하지 않는다. Agent identity, 위임자, effect, policy decision은 별도 계약으로 보존해야 한다.
제안: Golden Path를 세 축의 계약으로 바꾼다
새 플랫폼을 따로 만드는 대신 기존 service template에 세 개의 독립된 section을 추가한다.
apiVersion: platform.example.io/v1
kind: WorkloadIntent
metadata:
  owner: search-ml
spec:
  actor:
    type: ml-engineer          # human | ml-engineer | ai-agent | controller
    principal: team/search-ml
    delegatedBy: user/1234
  accelerator:
    class: latency-critical-inference
    quantity: 2
    maxQueueTime: 3m
    maxRunCost: 180000KRW
  autonomy:
    level: guarded-write       # read | propose | guarded-write | autonomous
    allowedEffects: [deploy-canary, scale-within-limit, rollback]
    expiresAt: 2026-10-11T18:00:00+09:00
  artifacts:
    imageDigest: sha256:...
    modelDigest: sha256:...
    evaluationRef: eval/search-reranker/1842
  objectives:
    p95Latency: 250ms
    maxCostPer1kRequests: 35KRW
이 schema 이름과 field는 표준이 아니라 조직이 소유할 예시다. 중요한 것은 portal, CLI, GitOps, agent tool이 모두 이 contract를 만들고 같은 admission path를 통과한다는 점이다. 각 축은 다음 질문에 답한다.
| 축 | 플랫폼이 받아야 할 intent | 플랫폼이 결정할 것 | 남겨야 할 증거 |
|---|---|---|---|
| Actor | 주체, 조직, 위임자, 목적, 만료 | 인증, tenant, 승인권자, impersonation 금지 | actor·delegator·session·decision ID |
| Accelerator | 성능 class, 수량, deadline, 비용 상한 | device/region/queue 배치, quota, sharing | claim·queue wait·실제 device·사용량 |
| Autonomy | 허용 effect, 환경, 횟수, 시간 | 자동 실행·승인·차단·rollback 조건 | proposal·approval·effective arguments·result |
이렇게 해야 “누가 요청했나”와 “어디에 배치됐나”, “얼마나 자동으로 실행됐나”를 독립적으로 바꿀 수 있다. 예를 들어 같은 ML engineer도 development에서는 interruptible GPU를 자동 사용하고, production model promotion에는 사람 승인을 요구할 수 있다. 같은 agent도 telemetry read는 자동 수행하지만 GPU fleet 확대는 비용 owner의 승인을 기다리게 할 수 있다.
Actor 축: persona가 아니라 책임과 위임을 모델링하라
CNCF 글의 Multi-Persona Experience는 data scientist·ML engineer, leader, security/compliance, AI agent까지 사용자를 넓힌다.[1] 핵심은 탭을 늘리는 것이 아니라 각 actor의 intent와 책임 범위를 machine-readable하게 만드는 것이다.
Human developer와 ML engineer
개발자의 기본 단위가 service와 release라면 ML engineer에게는 experiment, dataset snapshot, model, evaluation, endpoint도 중요하다. AI Golden Path는 다음 연결을 강제한다.
code revision → image digesttraining code + dataset snapshot + parameters → model digestmodel digest + prompt/config + evaluator version → evaluation resultapproved evaluation → serving revision → endpoint
CNCF whitepaper는 model을 OCI artifact처럼 다루면 caching과 signing, validation, attestation, provenance를 적용할 수 있다고 설명한다.[3] Kubeflow Hub의 Model Registry component는 model, version, artifact metadata와 그 lineage·reference를 관리하는 중앙 index다.[7] Registry가 promotion policy를 대신 집행한다고 확대 해석하지 말고, 플랫폼이 이 reference를 검증해 digest와 evaluation evidence가 없는 model을 production에서 거부해야 한다.
FinOps와 security는 관찰자가 아니라 decision participant다
OpenCost는 Kubernetes의 infrastructure와 container cost를 측정·할당해 실시간 cost monitoring, showback, chargeback을 지원하는 vendor-neutral specification과 구현을 제공한다.[8] 그러나 dashboard를 보는 것만으로 Embedded FinOps가 되지는 않는다. 비용은 provisioning 이후 보고서가 아니라 admission input이어야 한다.
예를 들어 platform은 accelerator class를 실제 가격표와 mapping해 예상 상한을 계산하고, maxRunCost, owner, cost center, TTL이 없으면 training job을 admit하지 않는다. 실행 뒤에는 estimate와 actual의 오차를 기록하고 다음 request의 default를 조정한다. 예산 초과 시 무조건 kill하는 대신 workload class별로 queue, downgrade, approval escalation, stop 중 하나를 명시한다. 이 규칙은 이 글의 운영 제안이며 OpenCost가 자동으로 제공하는 workflow가 아니다.
Security도 배포 마지막의 scanner owner가 아니다. 허용된 model license, dataset classification, region, external endpoint, tool effect를 policy input으로 정의하고 예외의 owner와 만료를 관리해야 한다. OPA는 policy decision을 API로 질의할 수 있는 범용 policy engine을 제공한다.[10] 하지만 중요한 것은 engine 이름보다 모든 client가 같은 결정 지점을 우회하지 못하는가다.
AI agent는 service account가 아니라 위임된 actor다
장기 service account 하나로는 “누가 어떤 목적으로 어디까지 맡겼는가”가 사라진다. Agent workload identity, delegating principal, task ID, scope, expiry를 분리하고 sub-agent가 권한을 넓히지 못하게 한다. Agent API에는 action, precondition, dry-run, effect, idempotency, 결과 조회를 구조화하되 사람용 endpoint와 최종 admission·audit는 공유한다.
Accelerator 축: upstream 기능은 contract 구현 예시다
GPU node pool만으로 self-service가 되지는 않는다. 플랫폼 계약은 발견, admission, allocation, 실행, 회수, 비용 귀속을 묶되 upstream API와 maturity를 숨기지 말아야 한다.
| 계약 지점 | 구현 예시와 maturity | 플랫폼이 고정할 contract와 evidence |
|---|---|---|
| Device allocation | Kubernetes 1.34에서 DRA core resource.k8s.io/v1이 GA가 됐다. 반면 consumable capacity, device health 같은 확장 기능은 각 feature별 alpha·beta 상태가 별도다.[4] |
interactive-notebook, interruptible-training 같은 intent를 검증된 DeviceClass·ResourceClaim mapping으로 변환하고 cluster version, driver, mapping version, 실제 device를 기록한다. |
| Queue·quota | 이 글에서 사용하는 Kueue의 ResourceFlavor, ClusterQueue, LocalQueue, AdmissionCheck contract는 공식 API reference의 kueue.x-k8s.io/v1beta1 CRD 기준으로 고정한다.[5][13] |
queue_wait, deadline, quota, checkpoint 조건을 노출하되 내부 CRD version을 사용자 contract로 고정하지 않는다. 직접 Pod 생성도 같은 admission·quota를 거치게 한다. |
| Inference routing | InferencePool inference.networking.k8s.io/v1은 v1.0부터 GA다. 그러나 endpoint 선택 알고리즘, metric, model-server 호환성과 EPP 운영 기능은 gateway·EPP 구현마다 다르다.[6] |
Model revision, traffic split, latency·cost objective, rollback threshold를 endpoint contract로 만들고 선택 근거와 실제 backend를 read-back한다. |
따라서 GA label 하나로 전체 경로가 안정됐다고 판단하면 안 된다. Cluster와 driver 조합, queue CRD, gateway·EPP 구현을 compatibility matrix로 검증한다. GPU utilization만 높이는 것도 성공이 아니다. Time-to-first-token, queue depth, 품질, request cost를 함께 보고 contract를 위반하면 promotion을 멈춘다.[12]
Autonomy 축: 승인 이후에도 닫히는 enforcement contract
Read, propose, guarded write, autonomous 같은 사다리보다 중요한 것은 쓰기 경로의 강제 조건이다. Policy engine은 prompt의 약속이 아니라 actor, delegation, effect, 환경, resource ceiling을 deterministic input으로 평가한다. 승인 화면에는 자연어 요약 대신 실제 적용될 normalized manifest, 예상 비용, 만료 시각을 보여주고 그 canonical payload의 approval_digest에 승인자를 결박한다. Argument가 한 글자라도 바뀌면 digest가 달라지므로 승인을 다시 받아야 한다.
반복 실행은 호출별 한도만으로 통제하지 않는다. task_id나 delegation 단위의 누적 token·GPU-hour·금액·횟수 budget을 admission 전에 원자적으로 예약하고 실행 뒤 actual을 정산한다. expires_at이 지났거나 잔여 budget이 부족하면 이미 열린 session과 retry도 차단한다. Sub-agent에는 남은 범위보다 넓은 capability를 발급하지 않는다.
마지막 gate는 API의 성공 응답이 아니라 effect read-back이다. Controller가 관측한 replica, traffic split, 실제 device, policy bundle, 비용을 승인된 digest와 대조하고 불일치하면 중단·rollback·escalation한다. Audit record에는 actor, delegated_by, task_id, approval_digest, policy_bundle, budget reservation·actual, expires_at, observed_effect를 함께 남긴다. 이 field들은 OPA나 SPIFFE의 표준 event가 아니라 플랫폼이 정의하고 모든 client에 강제할 감사 계약이다.
기존 Golden Path에 무엇을 더할 것인가
전면 재구축 대신 현재 path를 여섯 단계로 확장할 수 있다.
기존: source → build → scan → deploy → observe
확장: actor bind
      → code + model + data reference resolve
      → evaluation + policy + cost preview
      → queue/admit + accelerator claim
      → canary/serve with bounded autonomy
      → quality + SLO + cost evidence로 promote/rollback
- Template 입력 확장: owner, repository, CPU·memory는 유지하고 actor/delegation, model digest, dataset classification, evaluation, accelerator intent, autonomy, budget, TTL을 추가한다. 일반 web service에는 기존 default를 적용하고 AI artifact나 accelerator를 쓸 때만 관련 contract를 활성화한다.
- Decision packet 제공: 사람과 agent 모두 배포 전에 model·image digest, accelerator flavor와 queue, 비용, policy 예외, canary·rollback 조건, actor와 autonomy 만료를 같은 형식으로 받는다. Preview에 digest를 부여하고 실행은 그 digest를 참조해 승인 후 변경을 막는다.
- CI와 runtime policy 연결: license·signature·evaluation처럼 미리 아는 조건과 token rate·실제 비용·egress처럼 runtime에만 아는 조건을 분리하되 policy lineage는 공유한다. CNCF의 Security Shifts Down은 shift-left 폐기가 아니라 runtime layer의 보완이다.[1]
- FinOps loop 내장: estimate로 의사결정하고 admission에서 budget·quota를 예약하며 actual GPU time·model API·storage·network 비용을 actor와 workload에 귀속한다. 세 값의 오차를 다음 default에 반영한다.
- Evaluation을 promotion evidence로 사용: task별 evaluator와 threshold를 등록하고 evaluator version, dataset snapshot, result, 승인자를 보존한다. Model·prompt·retrieval configuration이 바뀌면 이전 승인을 재사용하지 않는다.
- Portal 대신 agent-safe API 제공: workload intent, dry-run, policy decision, 비동기 status, cancel·rollback을 구조화한다. MCP tool은 이 API의 좁은 capability이며 연결 자체는 authorization이 아니다. CNCF 글도 MCP gateway와 agentic guardrail을 capability로 언급할 뿐 구체적 권한 model을 표준화하지는 않는다.[1]
도입 순서: 기능 수가 아니라 계약의 닫힘을 기준으로
- GPU workload, model endpoint, agent account, 비용 owner를 inventory로 만들고 actor와 resource 연결이 끊긴 곳을 찾는다.
- 사람용 path부터 model digest·evaluation, accelerator queue·quota, cost estimate–actual attribution으로 재현 가능하게 만든다.
- Agent에는 catalog, policy preview, queue, cost, telemetry의 read와 proposal만 열고 최종 manifest와의 차이를 측정한다.
- Canary, 제한된 scale, rollback처럼 되돌릴 수 있는 effect만 guarded write로 연다. Delegation·budget·expiry·approval digest가 빠지면 차단한다.
- False promotion, 낭비한 GPU-hour, 우회 시도, rollback latency의 evidence가 쌓인 effect만 autonomous로 승격한다. “모델이 똑똑해졌다”는 승격 근거가 아니다.
플랫폼 팀이 측정할 새로운 SLO
기존 deployment lead time과 platform adoption rate만 보면 AI-native path의 병목이 가려진다. 최소한 다음을 actor–accelerator–autonomy에 맞춰 나눈다.
- Actor: identity 없는 action, 만료된 delegation 차단, 예외 owner 누락
- Accelerator: queue wait, claim 실패, 실제 사용 시간, idle 회수, SLO당 비용
- Autonomy: proposal 승인·거절, 승인과 actual effect 불일치, rollback 시간, 누적 비용
- Artifact/Policy: digest 없는 model, stale evaluation, provenance 누락, CI–runtime policy version skew
KubeCon + CloudNativeCon North America 2026이 AI Inference + Agentic track을 신설하고 GPU scheduling, model serving, agentic workflow, observability를 production AI 주제로 묶은 것도 이 문제가 단일 component가 아니라 운영 체계의 문제임을 보여준다.[11] 그러나 conference track의 존재가 특정 architecture의 정답을 증명하지는 않는다. 조직의 SLO는 project 채택 수가 아니라 위 계약이 실제로 닫혔는지를 측정해야 한다.
결론
Platform Engineering 2.0의 핵심은 개발자 포털 옆에 AI 포털을 하나 더 만드는 것이 아니다. 기존 Golden Path의 장점인 self-service, 표준화, policy, observability를 유지하면서 승객, 희소 자원, 자동화 권한의 가정을 바꾸는 일이다.
Actor 축은 developer 한 사람 대신 ML engineer, security, FinOps, AI agent의 identity와 위임 책임을 같은 contract에 넣는다. Accelerator 축은 GPU를 정수형 resource가 아니라 queue·topology·비용·회수 조건이 있는 서비스로 만든다. Autonomy 축은 API 접근을 곧 자동 실행으로 취급하지 않고 read, propose, guarded write, autonomous effect를 나눈다.
성공은 자동 생성량이 아니라 범위 이탈, SLO당 accelerator 비용, model–evaluation–endpoint 재현성, actor별 비용·policy 귀속으로 측정한다. 개발자가 model, data, agent, accelerator와 함께 system을 만드는 만큼 새 플랫폼을 병렬로 세우기보다 기존 paved road를 actor-aware, accelerator-aware, autonomy-aware하게 넓혀야 한다.
Sources
[1] https://www.cncf.io/blog/2026/07/06/evolving-platform-engineering-for-ai-native-workloads [2] https://www.cncf.io/wp-content/uploads/2026/01/CNCF_Annual_Survey_Report_final.pdf [3] https://tag-runtime.cncf.io/wgs/cnaiwg/whitepapers/cloudnativeai [4] https://kubernetes.io/blog/2025/09/01/kubernetes-v1-34-dra-updates/ [5] https://kueue.sigs.k8s.io/docs/concepts [6] https://gateway-api-inference-extension.sigs.k8s.io/api-types/inferencepool [7] https://www.kubeflow.org/docs/components/hub/overview/ [8] https://opencost.io/docs [9] https://spiffe.io/docs/latest/spiffe-specs/spiffe [10] https://www.openpolicyagent.org/docs/latest [11] https://www.cncf.io/announcements/2026/08/10/cncf-reveals-kubecon-cloudnativecon-north-america-2026-schedule-adds-new-ai-inference-agentic-track [12] https://www.cncf.io/blog/2026/03/26/the-platform-under-the-model-how-cloud-native-powers-ai-engineering-in-production [13] https://kueue.sigs.k8s.io/docs/reference/ [14] https://spiffe.io/docs/latest/spire-about/spire-concepts